응답 구성
AI · 이해와 구성
대화 내용과 상호작용 상태를 구성하여 소리와 캐릭터가 같은 응답을 표현하도록 합니다.
공간과 환경
소리, 가상 캐릭터, AI 상호작용이 함께 만드는 공간 경험을 탐색합니다.
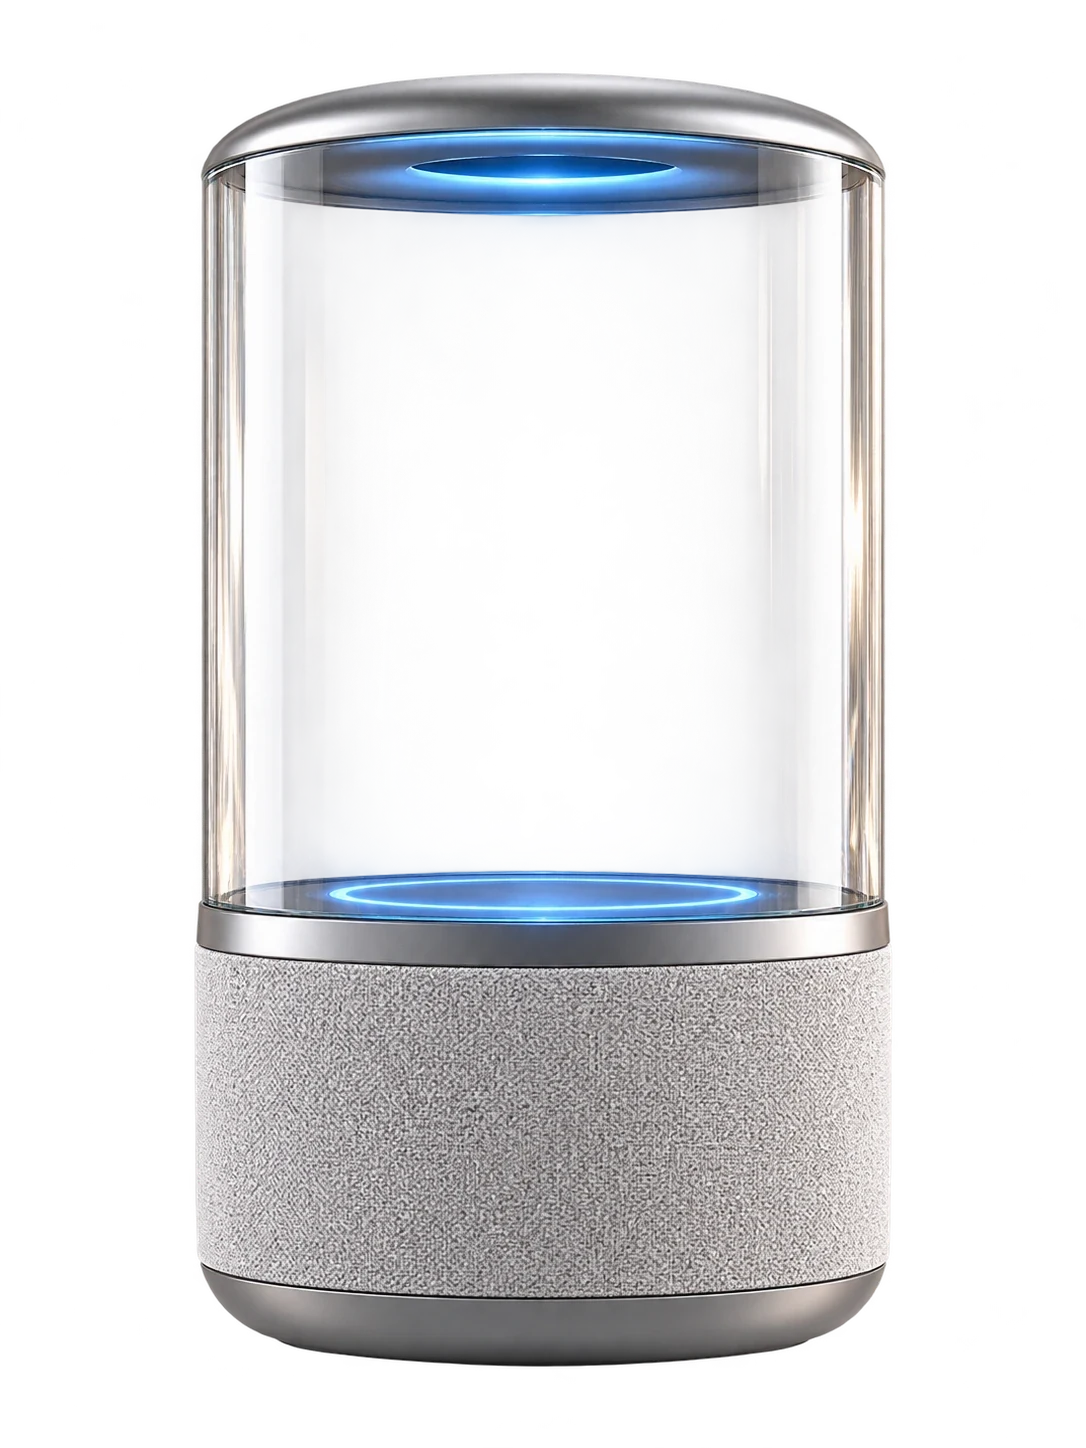
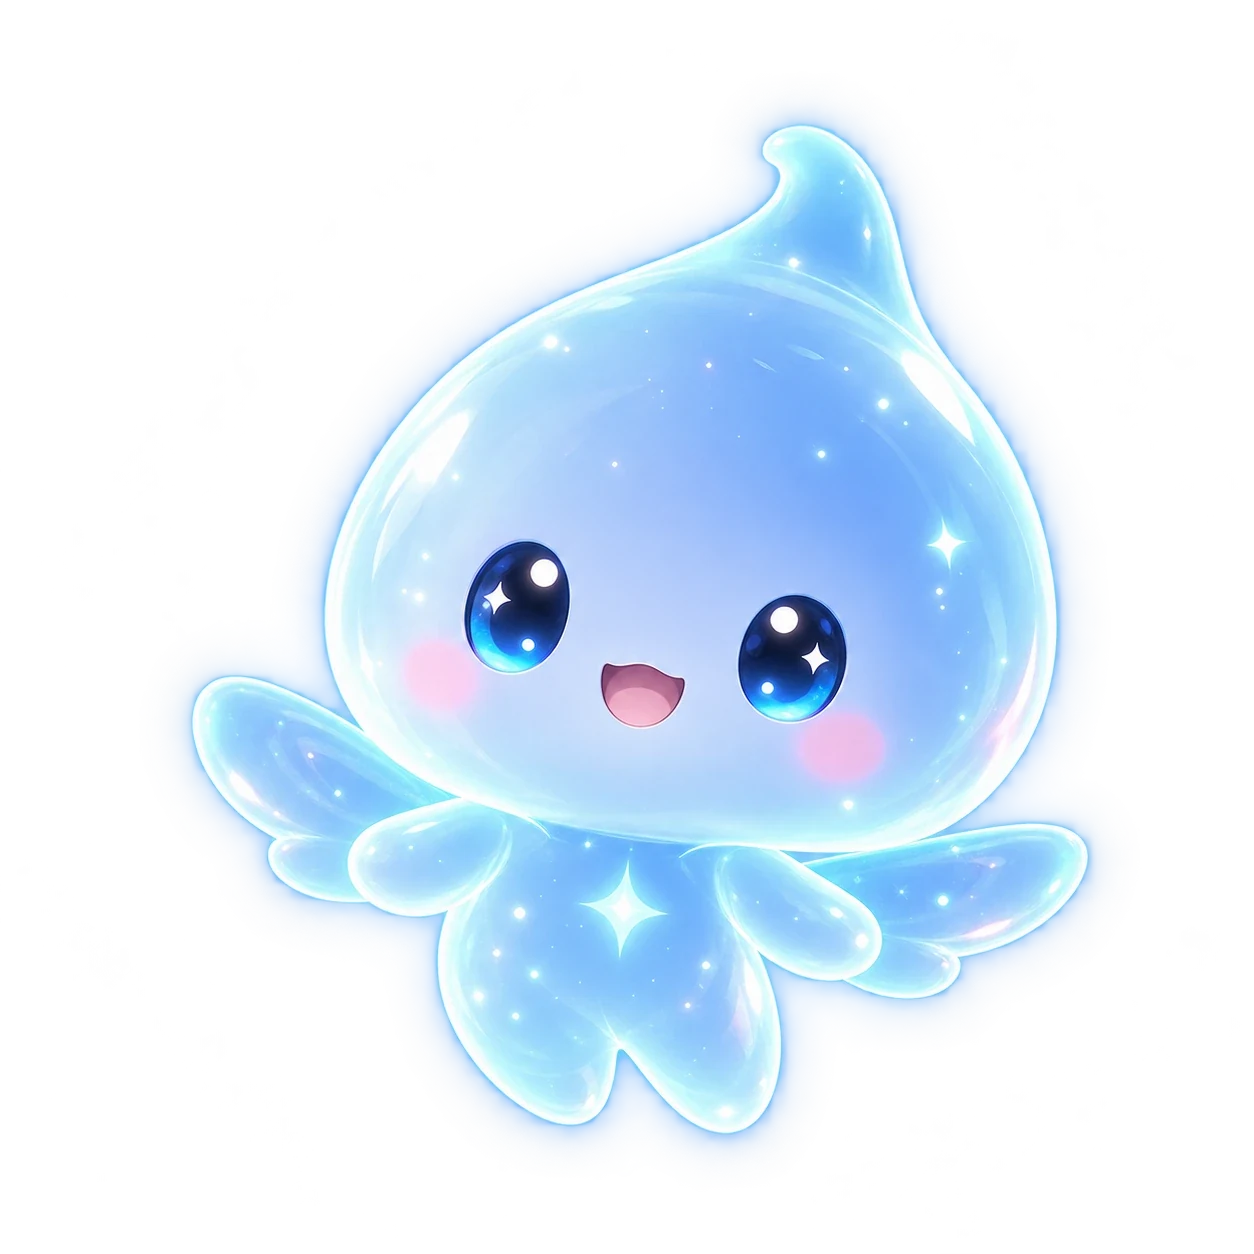
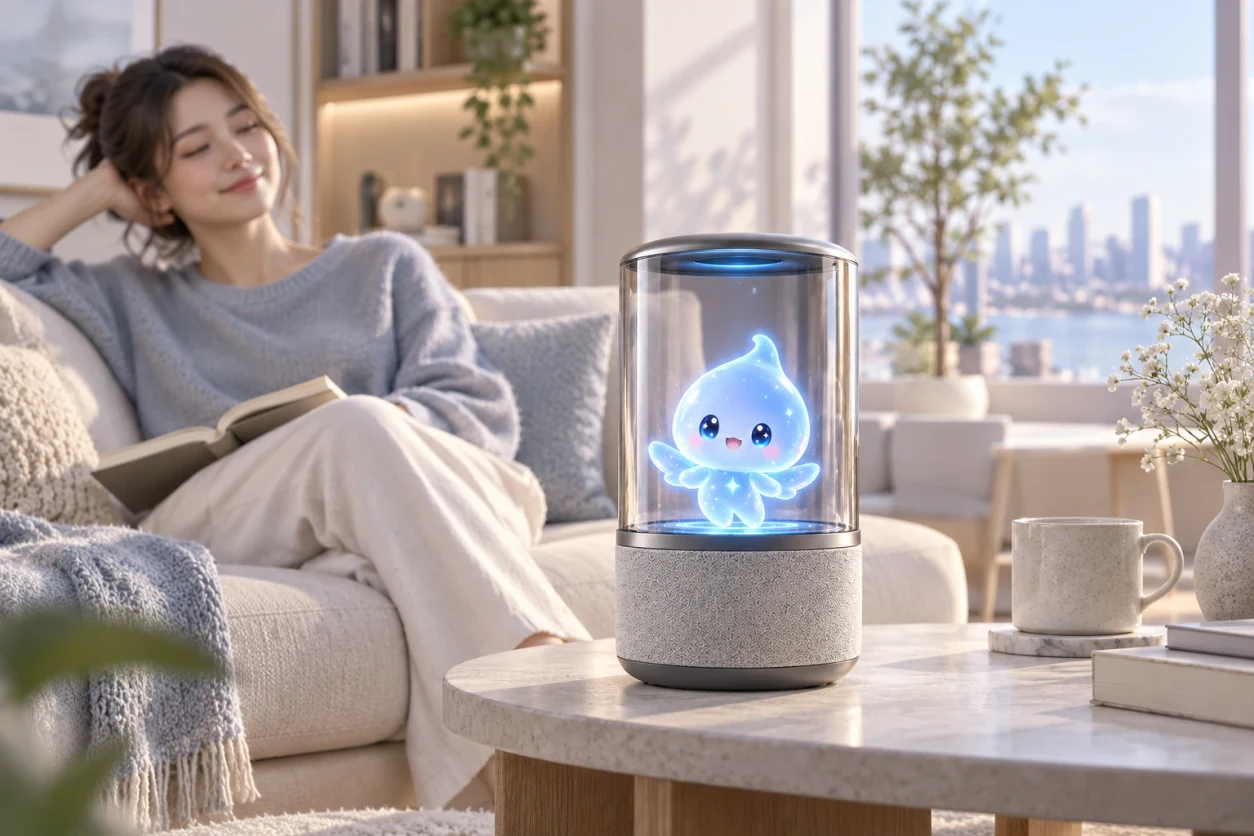
스피커 형태를 중심으로 음악과 대화에 눈에 보이는 움직임, 표정, 리듬을 더하는 방향을 탐색합니다.
음악 × 가상 캐릭터
이 경험 방향은 음악과 캐릭터의 동기화에 초점을 둡니다. 들리는 변화가 눈에 보이는 움직임의 변화로 이어집니다.
음악이 부드러워지면 캐릭터도 작은 움직임으로 반응합니다. 모든 곡에 춤이 필요한 것은 아닙니다.
입력의 변화가 뚜렷해질수록 캐릭터의 시각적 반응 범위도 커집니다.
파형이 평평해지고 캐릭터가 차분해지며 존재감을 낮춰, 공간에 다시 고요함이 돌아옵니다.
박자가 움직임을 이끌고, 강약이 움직임의 폭을 바꾸며, 음악 구간의 변화가 자세나 시각적 반응을 바꿉니다.
춤, 가벼운 흔들림, 표정, 입자 효과, 조명 등이 가능한 표현 방향입니다. 음악과 구체적인 제품에 따라 선택합니다.
음악이 끝나면 캐릭터는 자연스럽게 차분한 상태로 돌아갑니다.
공간 AI 스피커
오디오, 공간 시각 표현, AI 상호작용을 결합하는 제품 방향입니다. 구체적인 연동 효과는 제품에서 검증해야 합니다.
대화 내용과 상호작용 상태를 구성하여 소리와 캐릭터가 같은 응답을 표현하도록 합니다.
음악과 음성이 스피커에서 나와 내용을 귀로 들을 수 있게 합니다.
움직임과 표정으로 듣고 답하는 상태를 더 쉽게 알아볼 수 있게 합니다.
“잠깐 이야기 좀 나누자.”
캐릭터가 듣고 있는 상태를 보여 줍니다.
현재 대화에 맞춰 내용과 상태를 구성합니다.
답변을 들으면서 그에 맞는 표정과 움직임을 봅니다.
형태 방향: 스피커 받침대와 투명하거나 반투명한 시각 영역에 가상 캐릭터를 담습니다.
상호작용 방향: 움직임과 표정으로 듣기와 응답 같은 상태를 보여 줍니다.
사용할 공간과 상호작용 방식에 맞춰 소리, 캐릭터, 기기의 조합을 함께 논의합니다.